OpenObserve 與 OpenTelemetry:整合式觀測性平台介紹
前言
系統從單體走向微服務,從單一機房走向多雲與地端並存之後,「出了問題要去哪裡看」變得越來越難回答。一個使用者請求可能經過前端、多個後端服務與資料庫;記錄放在各台主機上,指標在另一套系統,追蹤又在第三套。排查時光是在不同工具之間切換、對時間、比對識別碼,就耗掉大半時間。
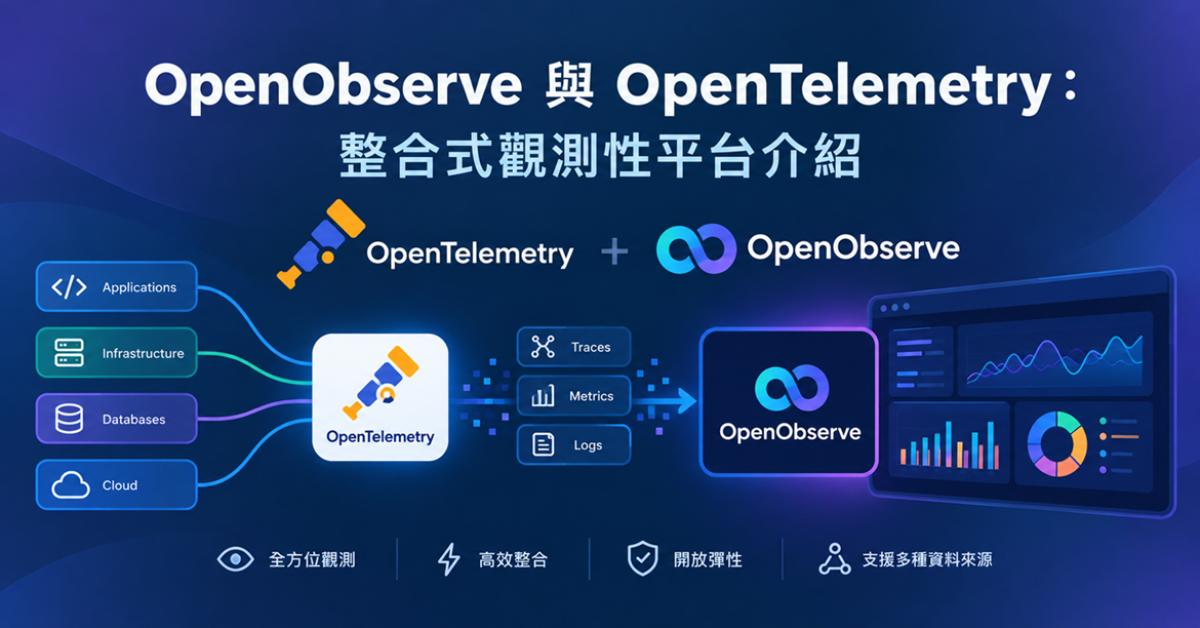
同一時間,OpenTelemetry(簡稱 OTel)已成為業界主流的遙測資料標準。資料的「產生與傳輸」有了共通語言之後,下一個問題是:資料要存在哪裡、用什麼來看?
本文介紹 OpenObserve,一個把記錄、指標、追蹤、儀表板與警示整合在同一個平台的開源方案,說明它與 OTel 搭配能帶來的好處,並誠實列出導入前需要留意的限制。內容有一部分來自我實際架設測試環境的經驗,並包含兩個不同環境、不同程式語言的實測案例:因雲端專案轉地端而測試的 Kubernetes 遙測與 Node.js 應用程式追蹤,以及內部虛擬機以 Docker 安裝的 OpenDGR 追蹤,詳見第七節。
一、先釐清:什麼是觀測性
傳統監控是預先決定要看什麼(CPU、記憶體、服務是否存活),超過門檻就發出警示,適合回答「已知的問題有沒有發生」。觀測性則要求系統輸出足夠豐富的資料,讓我們遇到「沒預料過的問題」時,也能事後從資料推敲原因。
三種核心訊號各自回答不同的問題:
- 指標(Metrics):隨時間變化的數字,例如 CPU 使用率、每秒請求數、錯誤率。體積小,適合看趨勢與設定警示。
- 記錄(Logs):事件的文字紀錄,細節最多,適合查證「當時到底發生了什麼」。
- 追蹤(Traces):一個請求跨越多個服務的完整路徑與每一段的耗時,適合回答「慢在哪裡」。
再加上儀表板(視覺化)與警示(主動通知),構成完整的觀測性能力。單看任何一種訊號都有盲點,真正的價值在於能把它們串起來看。
二、OpenTelemetry 為什麼重要
OTel 是由 CNCF 託管的開源專案,提供一套與廠商無關的標準,主要包含:
- SDK 與自動檢測:Java agent、Node.js、.NET、Python 等語言都有對應的檢測方式,多數情況不需修改程式碼就能產生追蹤與指標。
- OTLP 協定:遙測資料的標準傳輸格式,可透過 gRPC 或 HTTP 傳送。
- Collector:獨立的中繼程式,以「接收(receivers)、處理(processors)、匯出(exporters)」的管線運作,可以統一做批次、取樣、過濾與欄位轉換。
- 語意慣例(Semantic Conventions):統一屬性名稱,例如 service.name、deployment.environment.name,讓不同語言、不同團隊產生的資料能互相對得上。
對企業而言最大的意義是避免鎖定:應用程式只要輸出 OTLP,後端平台就可以更換,不必因為換了一套觀測平台,就得重新改寫每個服務的檢測程式。
需要提醒的是,各語言 SDK 對三種訊號的成熟度不一,導入前仍應確認所用語言與版本的支援狀況。
三、OpenObserve 是什麼
OpenObserve(常簡稱 O2)是一個開源的觀測性平台,把記錄、指標、追蹤放在同一個系統裡儲存與查詢,並內建使用介面、儀表板與警示。依官方說明與我的實測,主要特色如下:
- 一體化:單一平台涵蓋 Logs、Metrics、Traces,另外也提供 RUM(真實使用者監控)與 SLO 等功能。
- 原生支援 OTLP:可直接接收 OTLP/HTTP 與 OTLP/gRPC,透過 OTel Collector 的 otlphttp 匯出器即可送入。
- 相容既有生態:支援 Prometheus remote_write,既有的 Prometheus 與各種 exporter 不必重做,就能把指標送進來;官方也提供從 Prometheus 與 Mimir 遷移指標的文件(見延伸閱讀)。
- 熟悉的查詢方式:Logs 與 Traces 可用 SQL 查詢,Metrics 支援 PromQL。
- 儲存架構:設計重點是以物件儲存(如 S3 相容服務)搭配欄式格式儲存資料,目標是降低儲存成本。實際成本與效能會隨資料量與環境而異,建議用自己的資料實測,不要直接採信廠商宣稱的倍數。
- 部署彈性:可用單一容器快速啟動做驗證,也有叢集模式;提供自行架設與雲端託管兩種形式。
四、功能導覽
4.1 記錄(Logs)
集中查詢各主機與服務的記錄,可用欄位篩選或 SQL。我實測以 OTel Collector 的 journald receiver 蒐集 Ubuntu VM 的 systemd 以及 Windows VM 的記錄,並匯入 OpenObserve 查詢。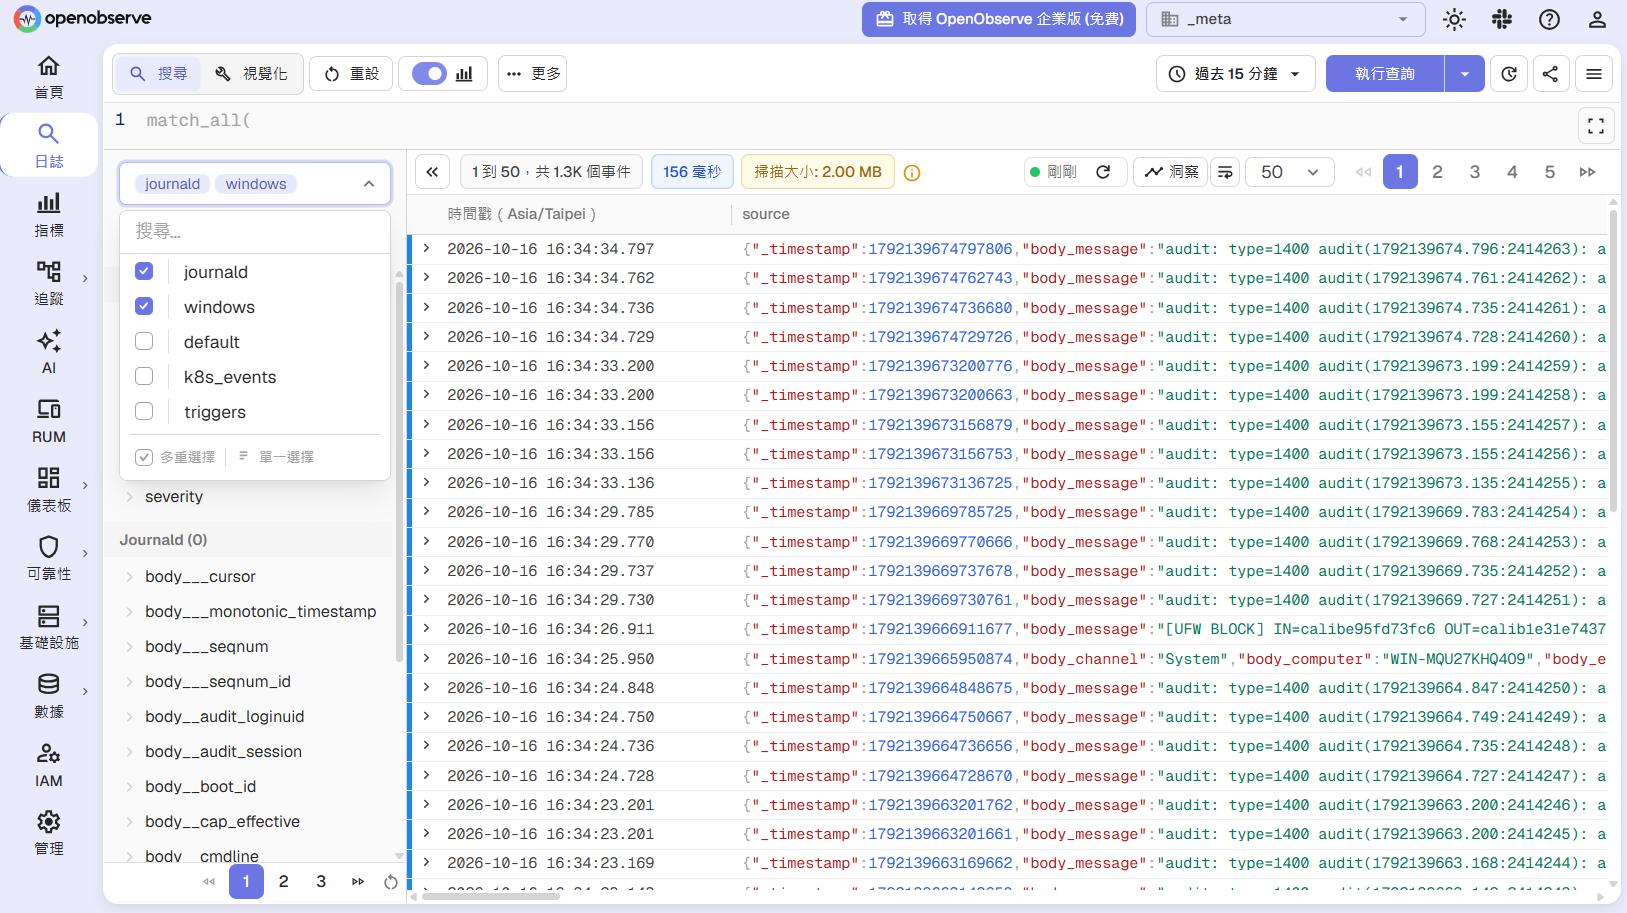
4.2 指標(Metrics)
可接收 OTel 指標(例如 hostmetrics receiver 蒐集的 CPU、記憶體、磁碟、網路),也能接收 Prometheus 格式的資料,並直接在儀表板上畫成趨勢圖。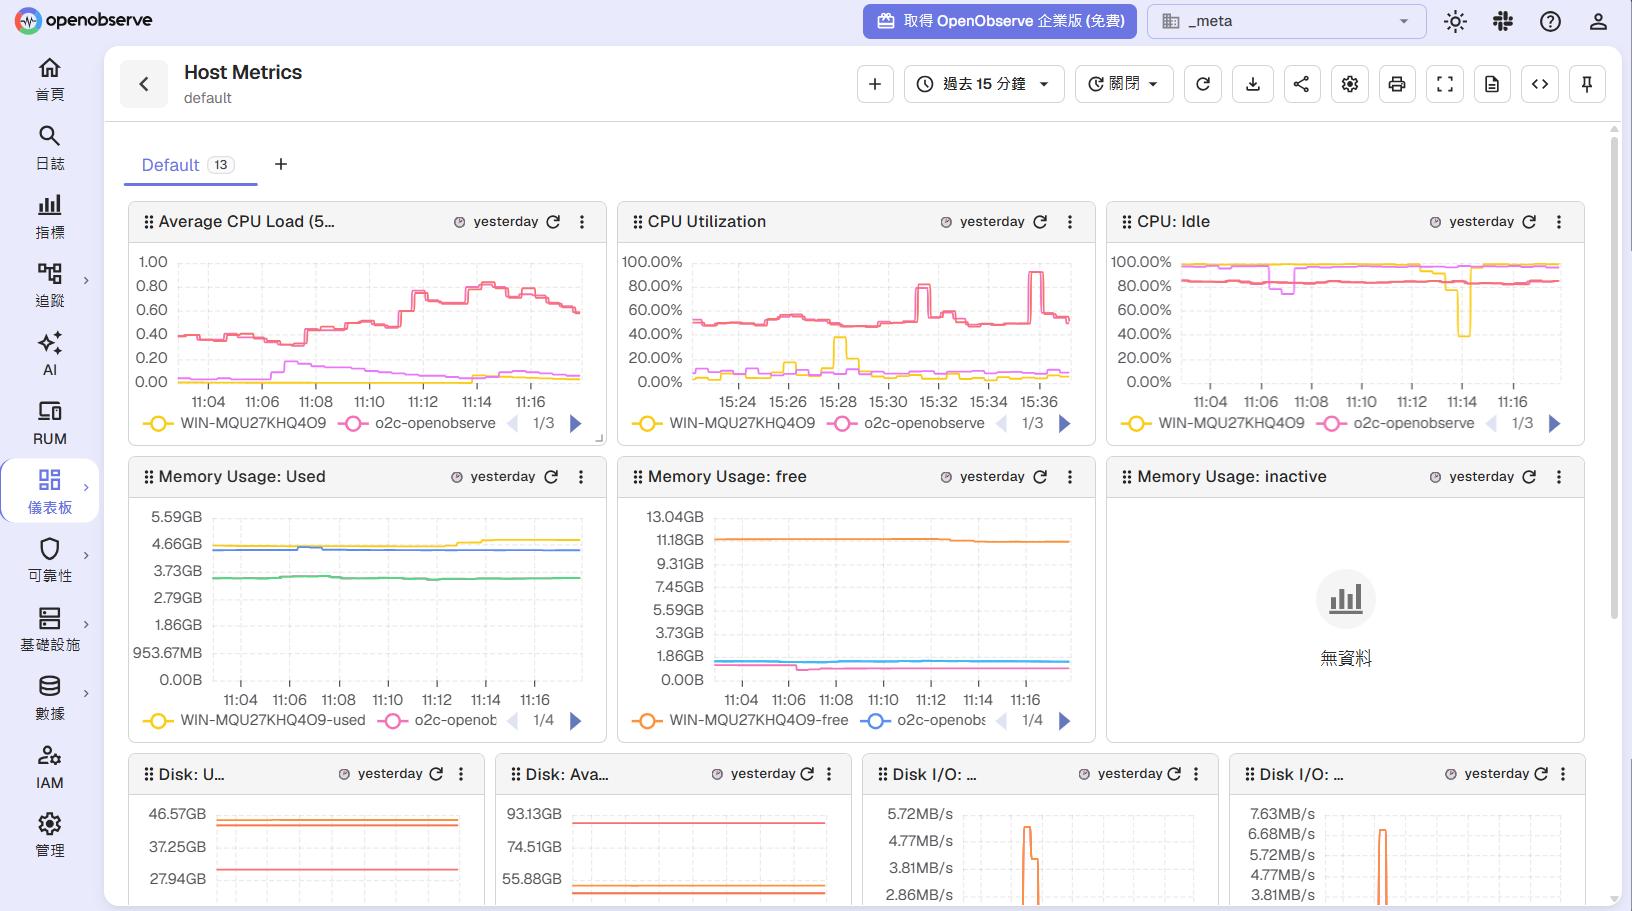
4.3 追蹤(Traces)
顯示一個請求跨服務的呼叫關係與各段耗時。OpenTelemetry 官方也提供一套 Demo 應用程式(模擬電商的多個微服務),可以用來測試追蹤等功能。
4.4 儀表板(Dashboards)
結構為「資料夾、儀表板、面板(Panel)」三層,內建多種圖表類型(折線、長條、表格、圓餅等),也有範本可用。表格面板支援樞紐(Breakdown)欄位做交叉整理;較進階的查詢可切換成自訂 SQL。
4.5 警示(Alerts)
可建立排程警示:定期執行查詢,符合條件就通知,通知目的地可設定為 Webhook、Email 等。我實測串接了 Discord,通知可以正常送出。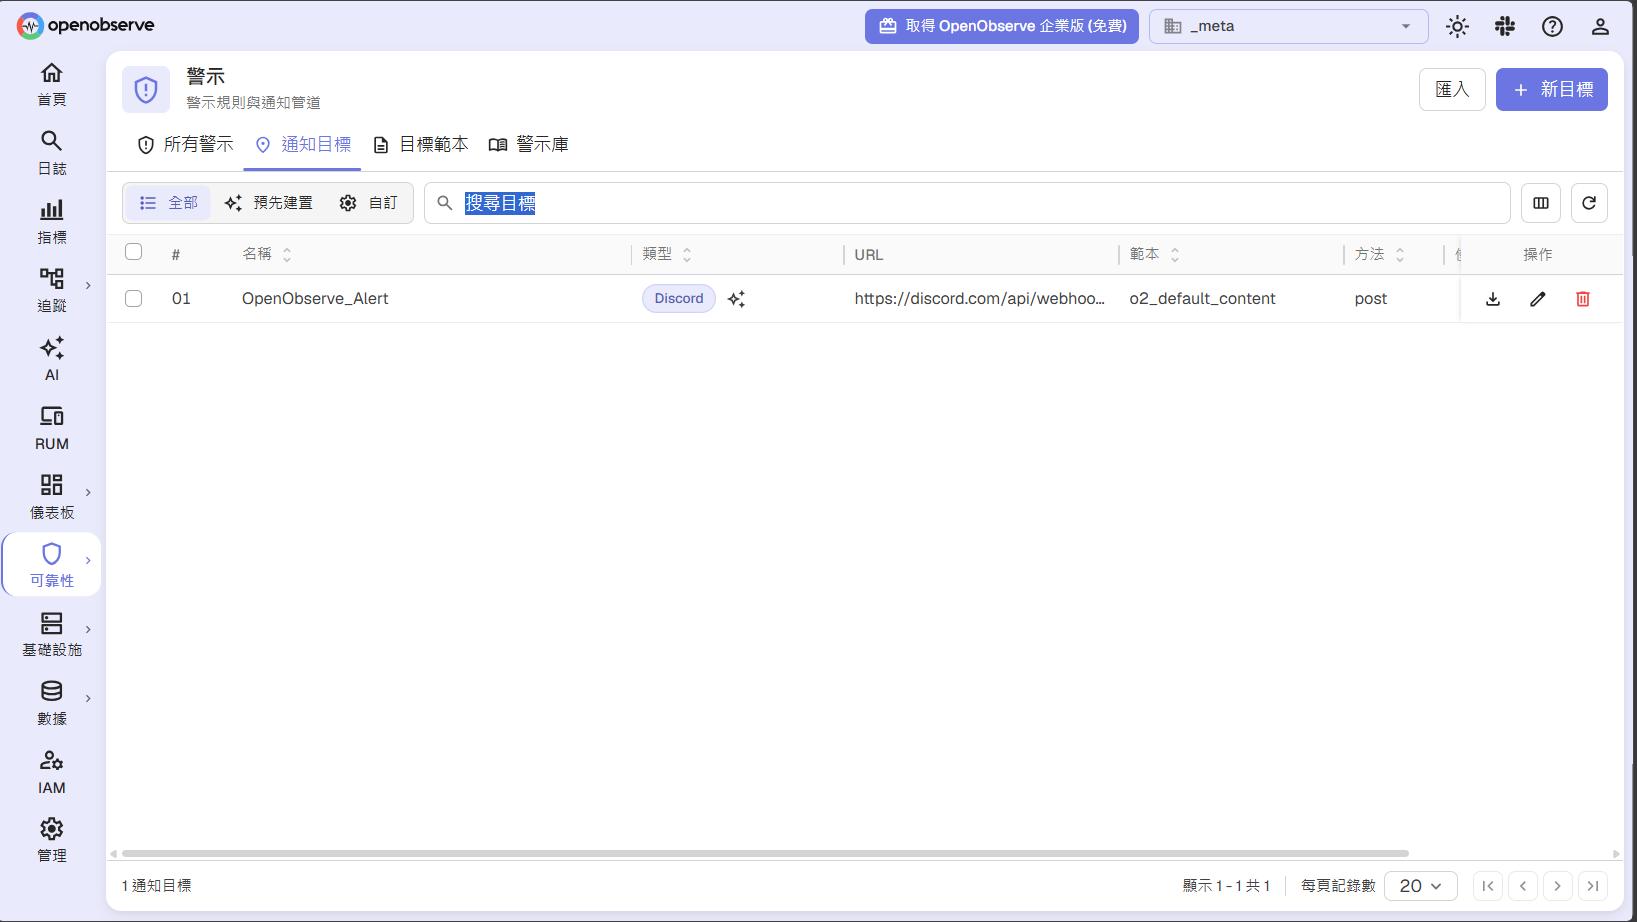
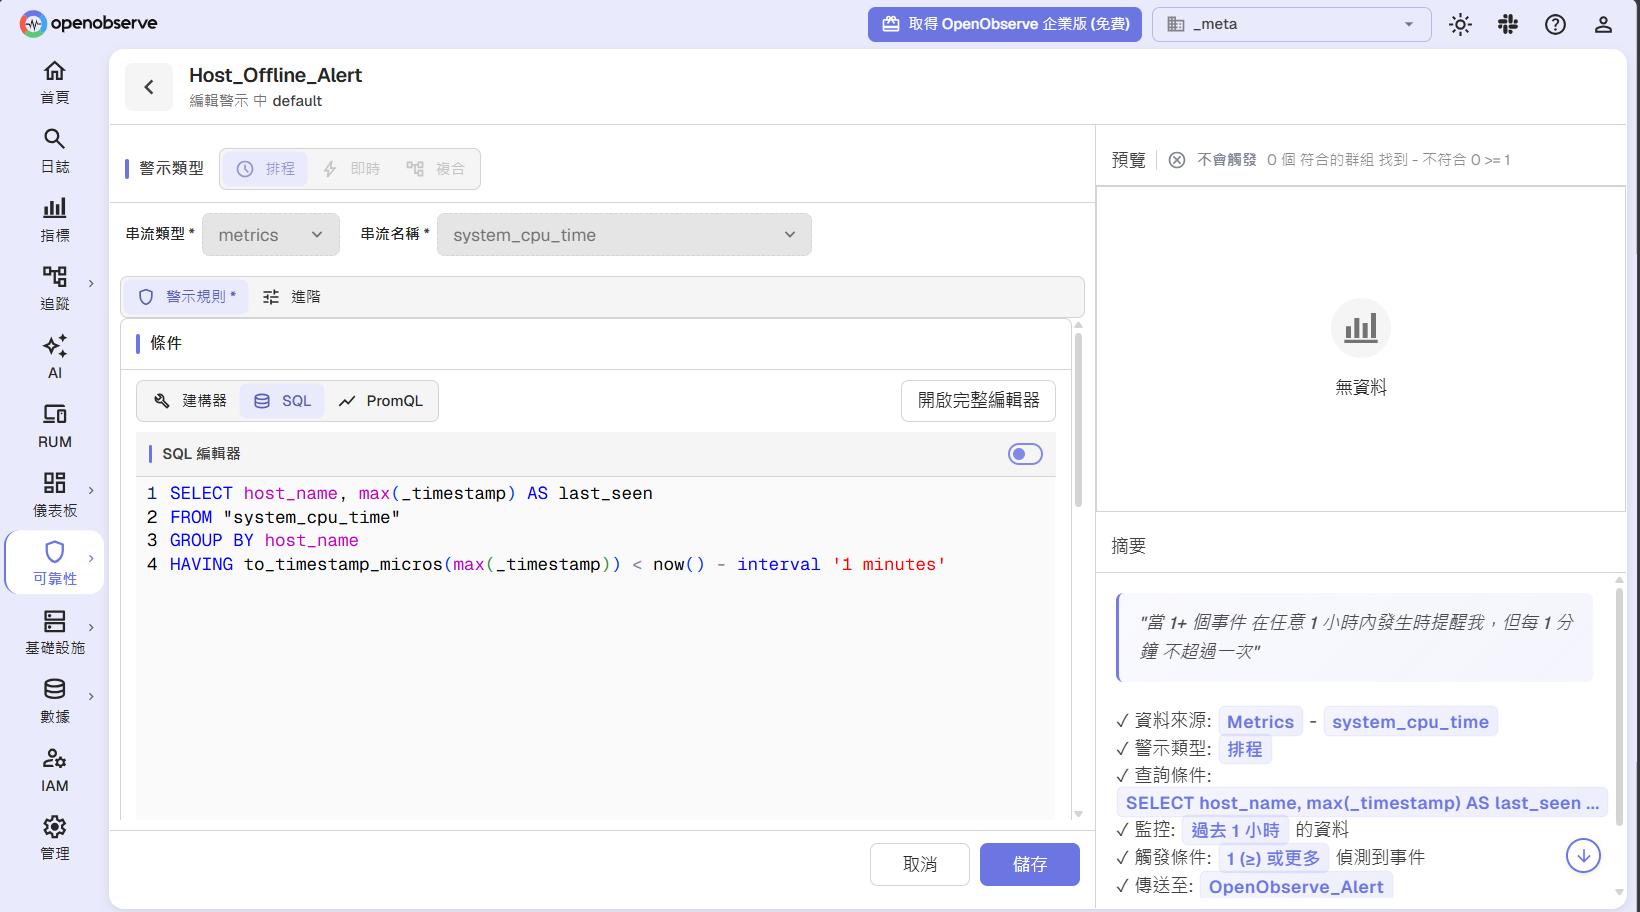
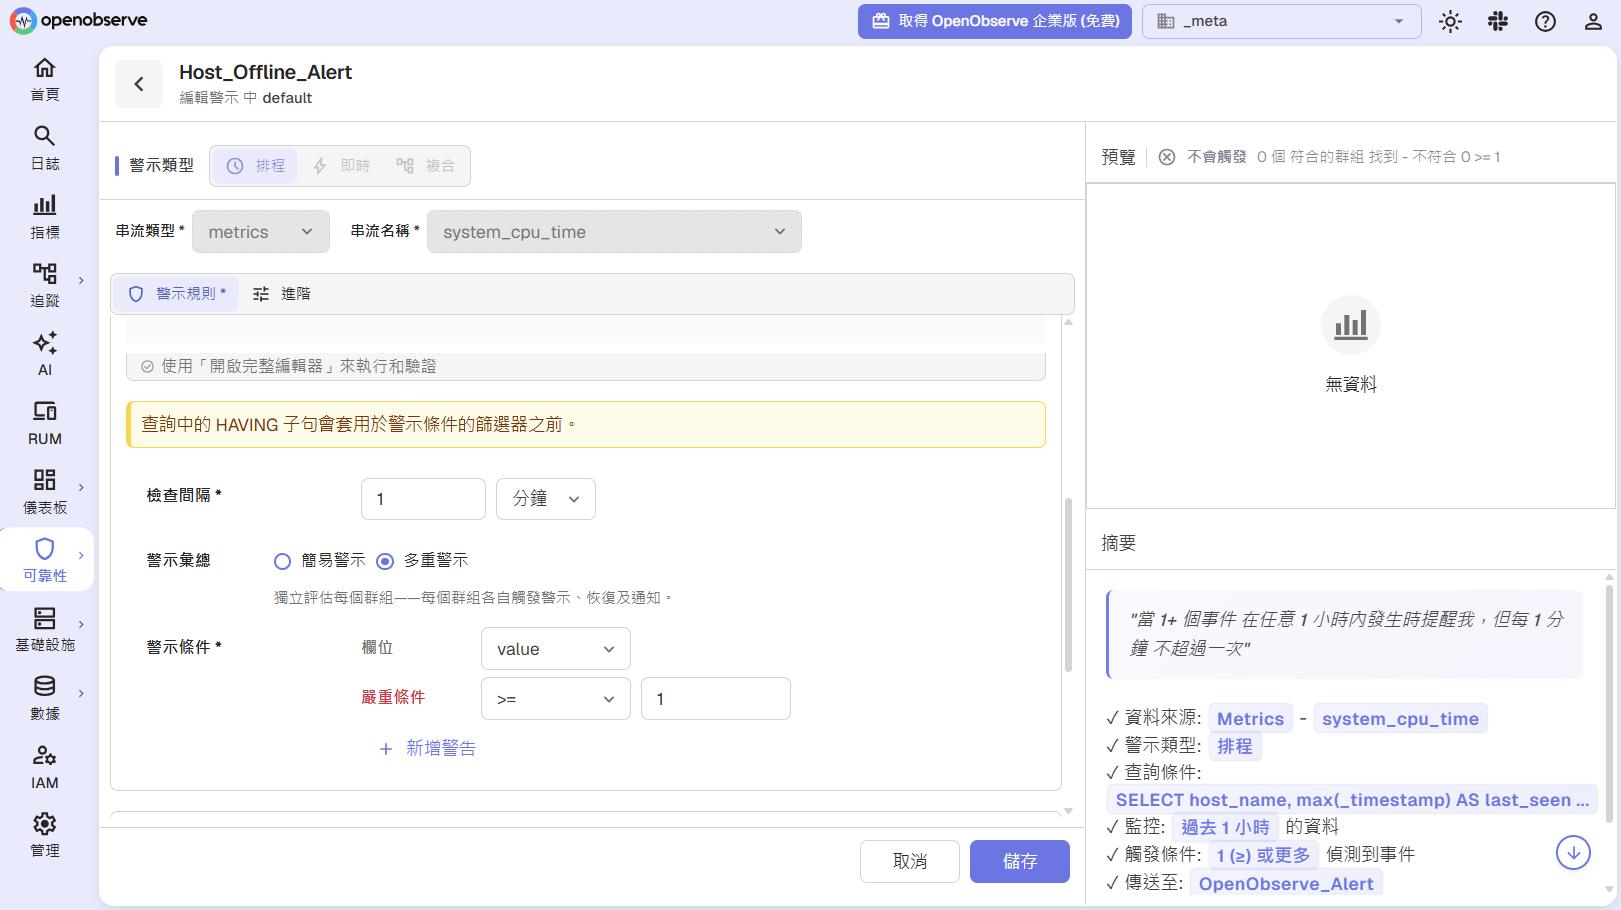
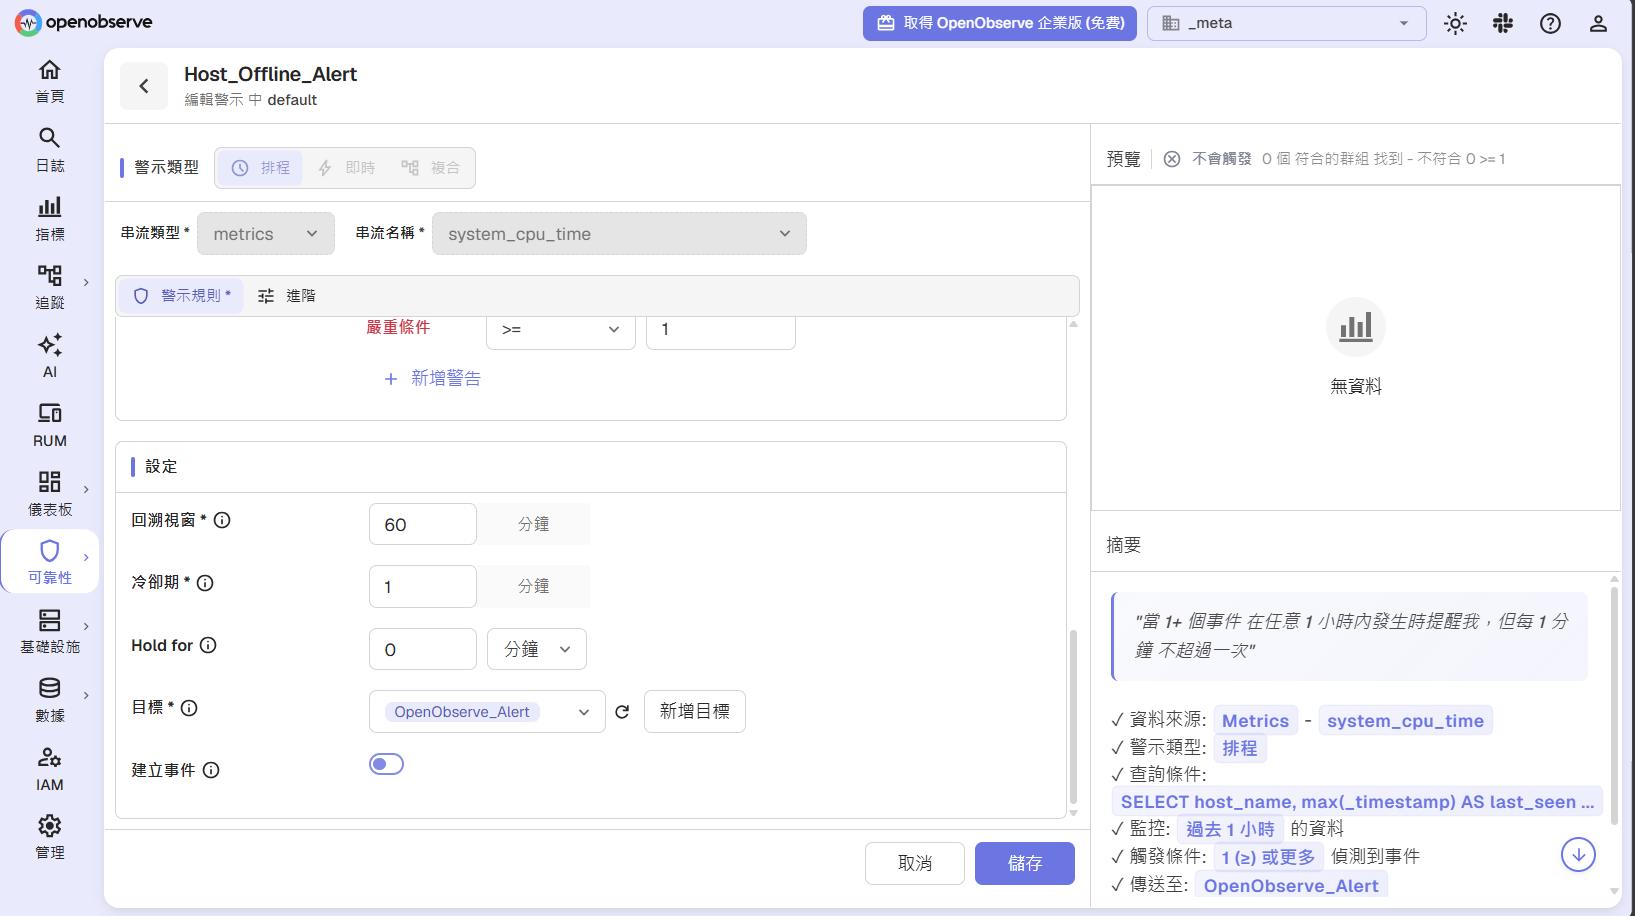
「機器下線」這類情境,因為平台沒有內建的主機存活狀態,做法是偵測「一段時間內沒有資料進來」,或使用 Collector 的 httpcheck receiver 這類主動探測的指標。我實測採用前者,下面的查詢已確認可以在主機停止回報後觸發警示,並透過 Discord 收到通知。
SELECT host_name, max(_timestamp) AS last_seen
FROM "system_cpu_time"
GROUP BY host_name
HAVING to_timestamp_micros(max(_timestamp)) < now() - interval '5 minutes'- 做法:以每台主機都會固定送出的 system_cpu_time 為對象,依 host_name 分組,找出最後一筆資料超過門檻(此例為 5 分鐘)的主機。警示類型為排程,警示彙總選「多重警示」,一條規則就能涵蓋所有主機,新主機只要有送這個指標就會自動納入。
- 觸發條件:查詢只會回傳離線的主機,所以條件要設成「筆數大於等於 1」,不是小於 1。
- 回溯視窗要大於判定門檻:例如視窗 60 分鐘、門檻 5 分鐘;否則主機離線超過視窗後會從結果消失,警示就不會再報。
- 限制:離線超過回溯視窗的主機不再被偵測;從未上線過的新主機偵測不到;判斷的是「資料有沒有進來」,Collector 停止與主機當機看起來是一樣的。
4.6 資料管線(Pipelines)
可在資料進入儲存前後做欄位轉換與過濾。不過我的作法是把轉換規則放在 OTel Collector 端(見第六節),讓規則與後端平台解耦。
五、整合式平台的好處
5.1 排查時不必在多個工具之間切換
同一個介面可以查記錄、指標與追蹤,並透過共同的屬性(例如 service_name、trace_id 等欄位)把它們串起來。實務上的排查路徑會變成:收到警示、打開儀表板確認範圍、點進追蹤找出慢的環節、再回頭看該時段的記錄。
5.2 維運元件變少
常見的自建組合是 Prometheus 做指標、Loki 做記錄、Tempo 做追蹤、Grafana 做視覺化,通常還要另外處理警示。每個元件都有各自的部署、升級、容量規劃、備份與權限設定。整合式平台把這些收斂成一套,維運負擔與出錯機會都跟著減少。
5.3 資料標準與治理可以一次定義
認證、保留期限、命名規範集中管理。搭配 Collector 的 transform processor,可以在資料進入平台之前,統一強制命名規範並遮蔽個人資料,不必依賴每個服務各自做對。
5.4 以 OTLP 為介面,降低鎖定風險
應用程式只認 OTLP 與 Collector,後端是 OpenObserve 還是其他平台,只需改 Collector 的匯出設定。這讓我們日後評估或更換後端的成本很低。
5.5 成本較可預期
以物件儲存為基礎的設計,在資料量大、保留期限長的情境下,儲存成本有機會比傳統做法低。再搭配 Collector 端的取樣,可以進一步控制進入平台的資料量。實際效益仍需依自己的資料量實測。
5.6 學習門檻較低
記錄與追蹤可以用 SQL 查詢,多數工程師都熟悉;既有的 PromQL 經驗也能直接用在指標上。
六、我的參考架構
我規劃的是多環境(AWS、GCP、Azure、地端)共用同一個後端的架構:
- 各環境的應用程式以 OTel 自動檢測(Java agent、.NET、Node.js)產生資料,送往同環境內的本地 Collector。
- 本地 Collector 負責批次與初步過濾,再轉送到中央 Gateway Collector。
- Gateway Collector 統一處理:命名規範強制(例如 service.name 轉小寫、必填屬性檢查)、個資遮蔽、追蹤取樣(錯誤全留、正常請求依比例取樣)。
- 最後匯出到 OpenObserve。
基礎設施層面:VM 上以 systemd 服務方式執行 otelcol-contrib,使用 hostmetrics 與 journald 蒐集主機資料;Kubernetes 環境可透過 OpenTelemetry Operator,用註解的方式自動注入檢測,不需修改映像檔。
這個架構的重點是規則放在 Collector,不放在各個服務。服務數量與語言越多,把規則集中在一個地方,越容易維持一致,也越容易調整。
七、實測案例:兩種環境、兩種語言
除了基礎環境的驗證,我剛好有兩個機會,把 OpenObserve 放進實際的應用程式環境測試:一個是 Kubernetes 上的 Node.js 應用程式,一個是虛擬機上以 Docker 執行的 Java 應用程式。以下記錄做法與過程中確認的事項。
7.1 案例一:Kubernetes 遙測與 Node.js 應用程式追蹤
某個雲端專案因需求要轉為地端部署,讓我有機會在地端的 Kubernetes 上,測試 OpenObserve 的 Kubernetes 遙測,以及對 Node.js 應用程式的追蹤。
- 環境:RKE2 v1.36.4 安裝的單節點架構、應用程式 Node.js 20.11.0
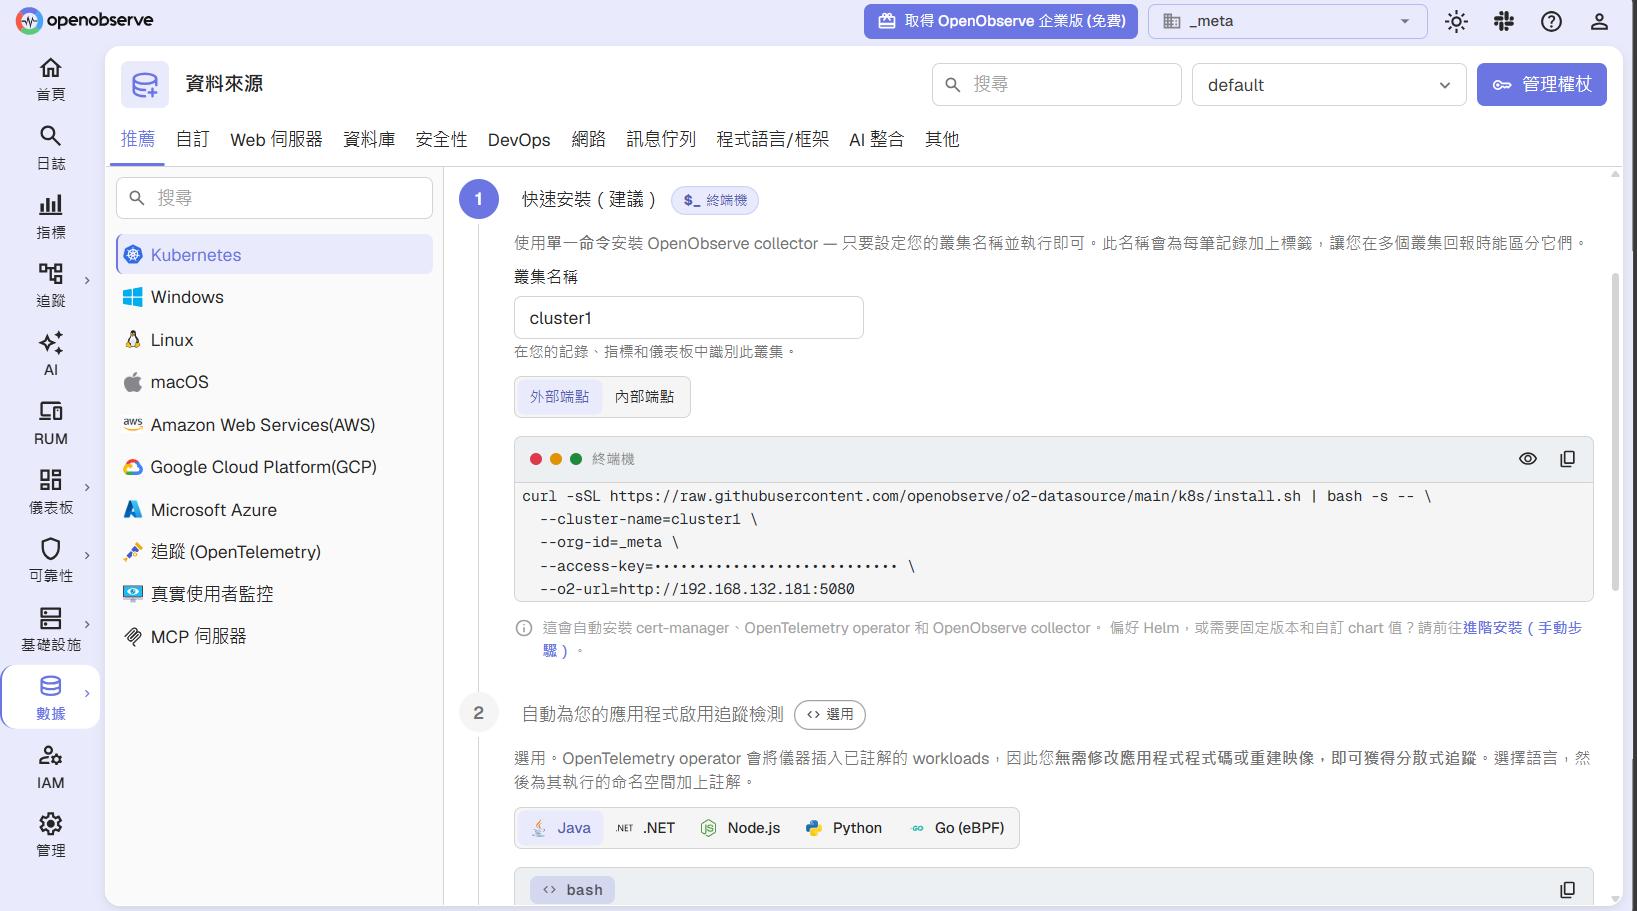
- 做法:依 OpenObserve 的 Kubernetes 資料來源導覽安裝 Collector,並啟用選用的「自動為應用程式啟用追蹤檢測」。它利用 OpenTelemetry Operator,在 Pod 建立時為有加註解的工作負載注入 Node.js 的檢測,不需修改程式碼,也不需重建映像檔。註解的名稱是 instrumentation.opentelemetry.io/inject-nodejs,值指向叢集內的 Instrumentation 資源。
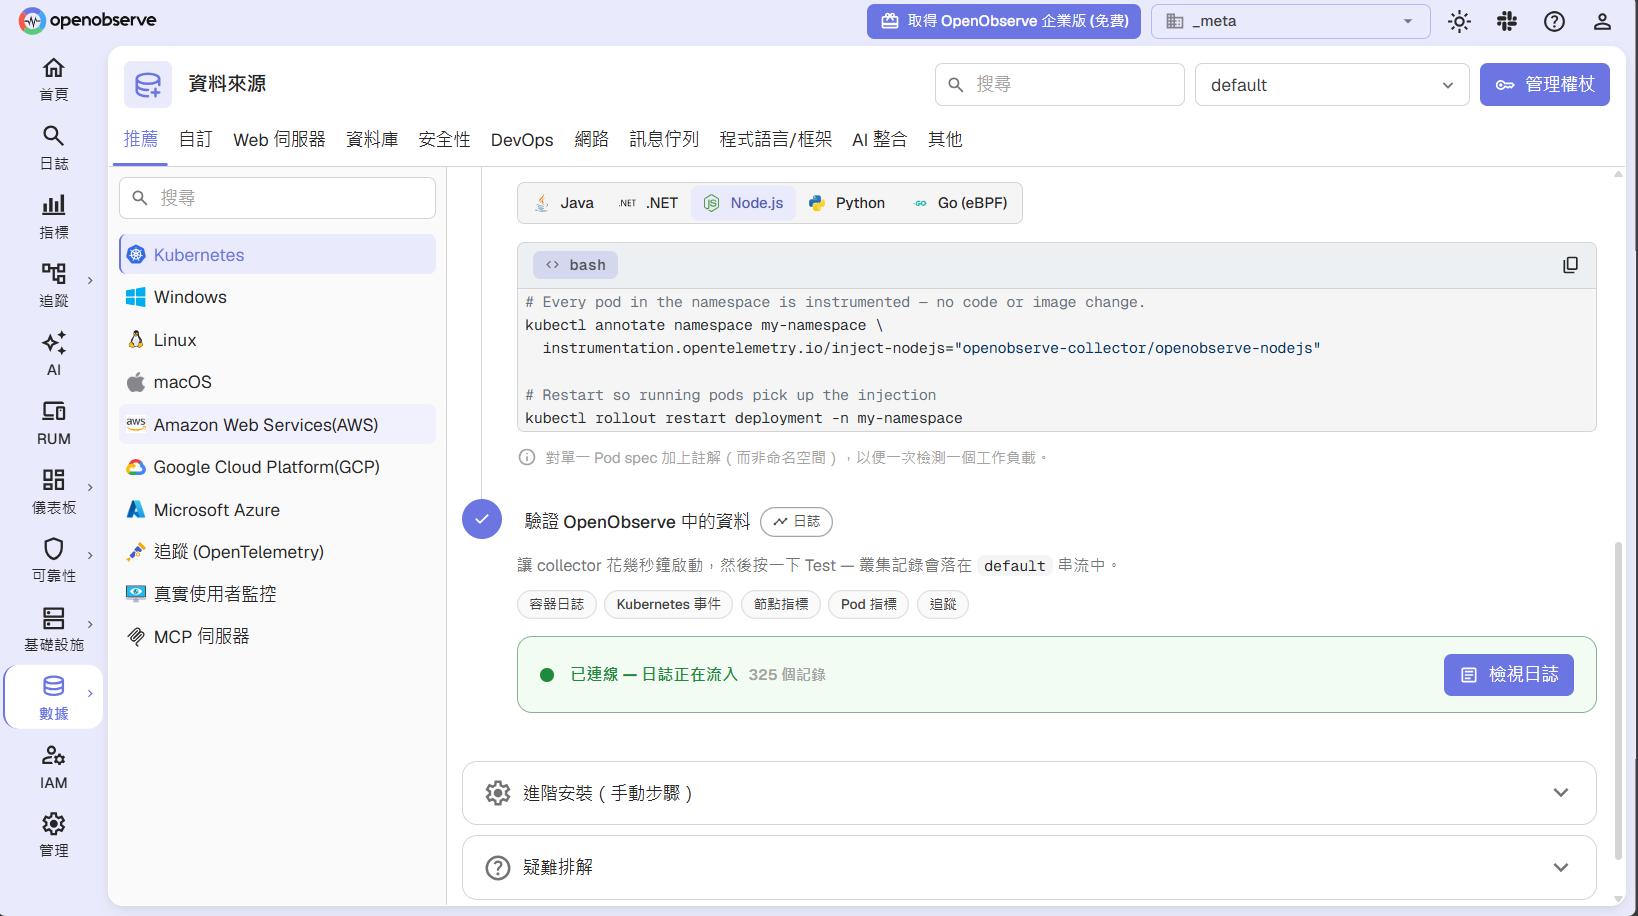
- **留意一:注入只發生在 Pod 建立的當下。**已經在跑的 Pod 要重建才會生效。官方範例是對整個命名空間加註解,再重啟所有 Deployment,風險較高;我傾向只對單一 Deployment 的 Pod 範本加註解,並透過既有的 CI/CD 在下次部署時自然帶入,先在測試環境驗證。
- **留意二:span 狀態是 UNSET 屬於正常。**這是 OTel 的預設值,表示沒有發生錯誤,也沒有被明確標記為成功;只有出錯時才會是 ERROR。
- **留意三:記錄裡的 trace_id 與 span_id 不一定有值。**通常只有經過有被檢測的日誌函式庫輸出的記錄,才會被自動帶上這兩個欄位;直接寫到標準輸出的記錄多半是空的,這與追蹤是否成功是兩件事。
- 結果:
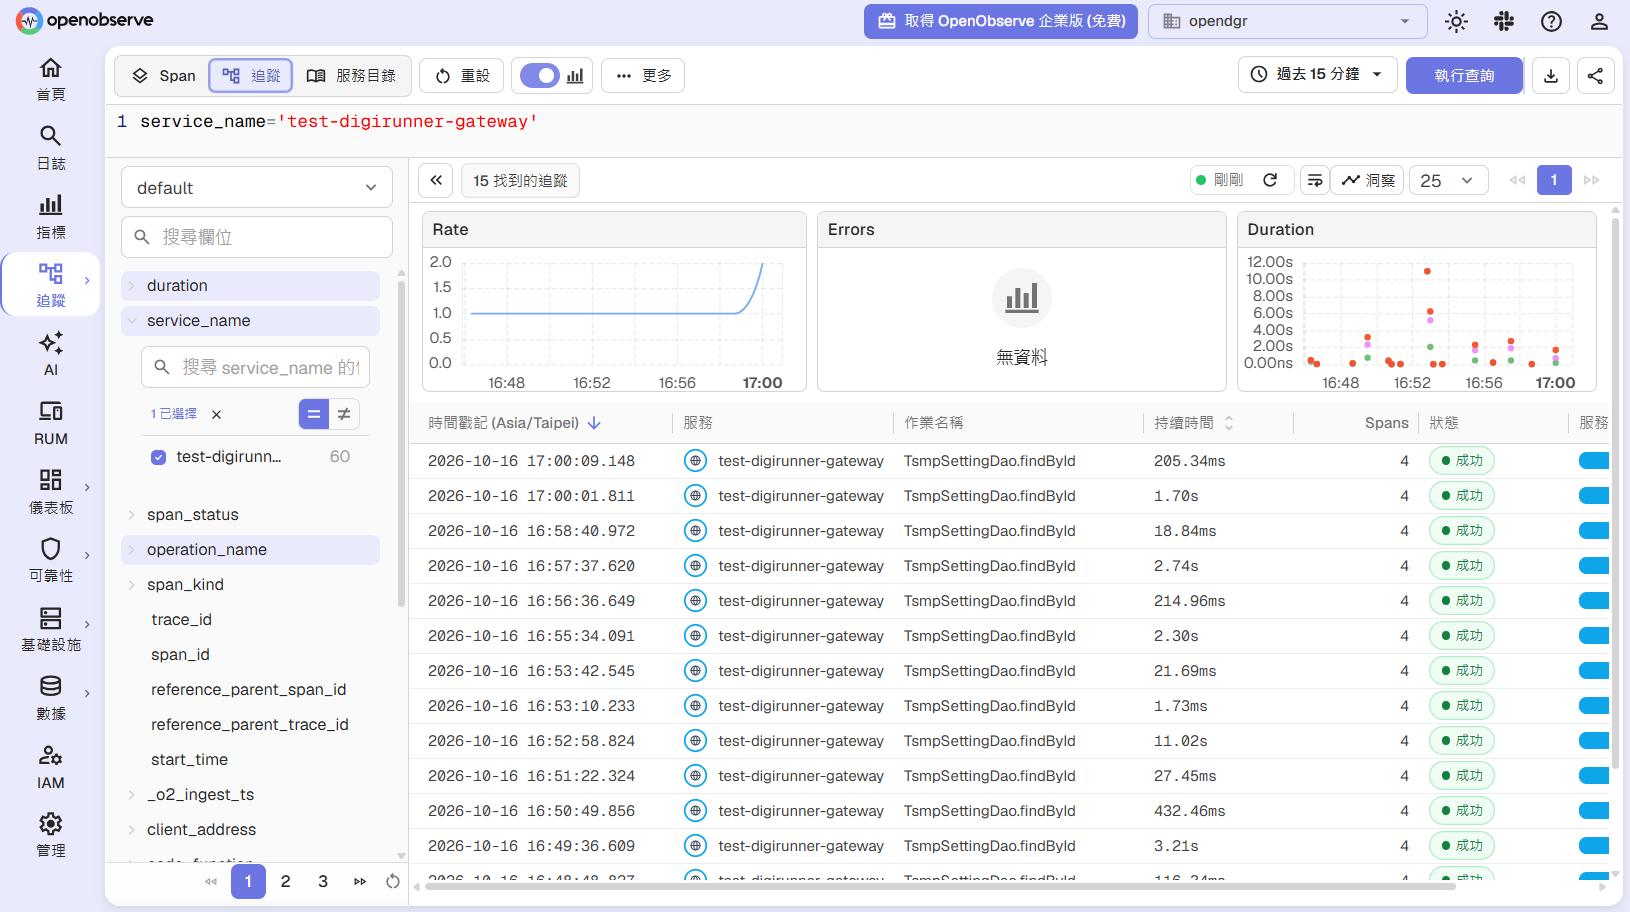
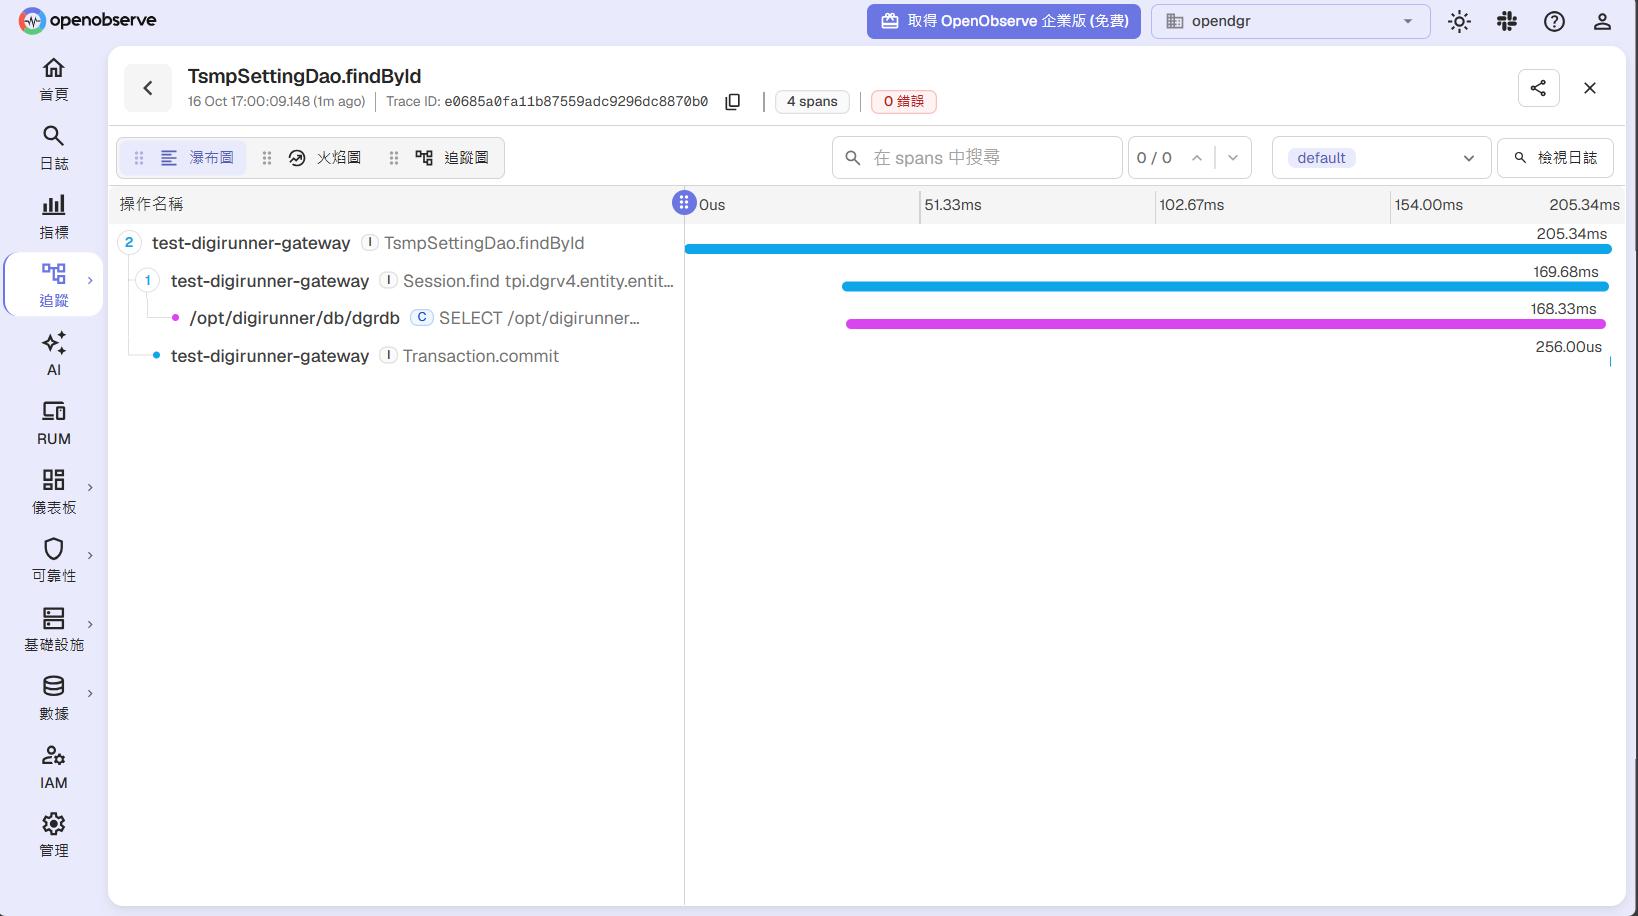
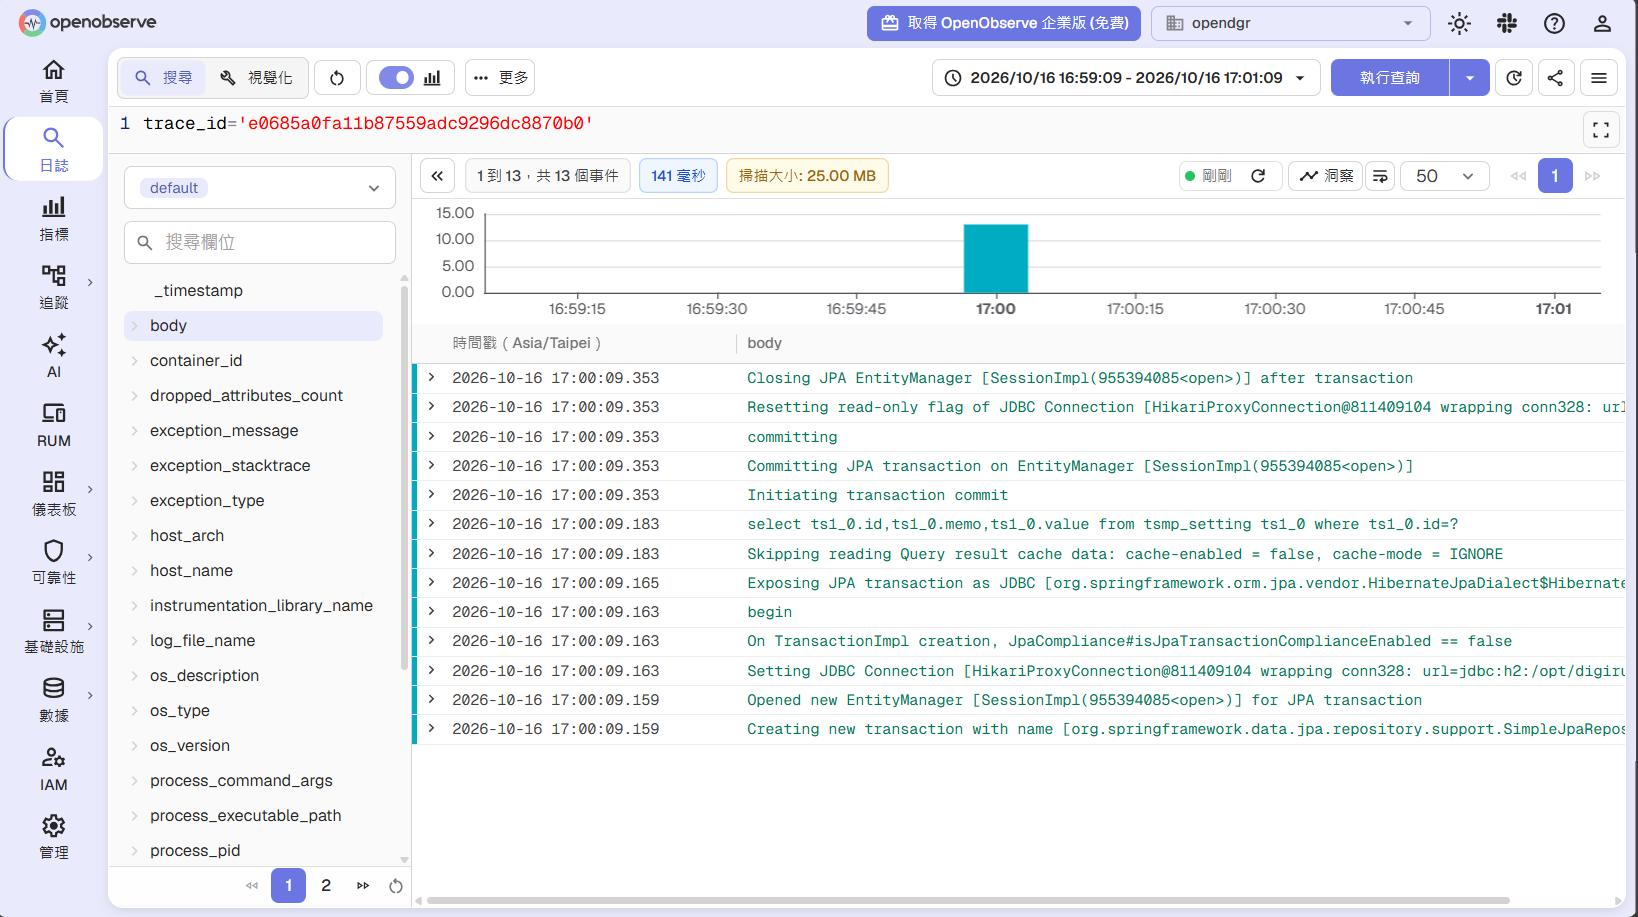
7.2 案例二:虛擬機上以 Docker 執行的 OpenDGR(Java)追蹤
內部虛擬機測試環境以 Docker Compose 安裝了 OpenDGR,我用它驗證容器內的 Java 應用程式如何接上追蹤。
- 做法:以 OpenTelemetry Java agent,透過 JAVA_TOOL_OPTIONS 環境變數載入,不改動原本的 compose 檔與啟動腳本。另外建立一份額外的 compose 設定檔,把 agent 檔案唯讀掛進容器,並設定服務名稱與 OTLP 端點;要還原時,只要不帶這份額外設定檔重新啟動該服務即可。
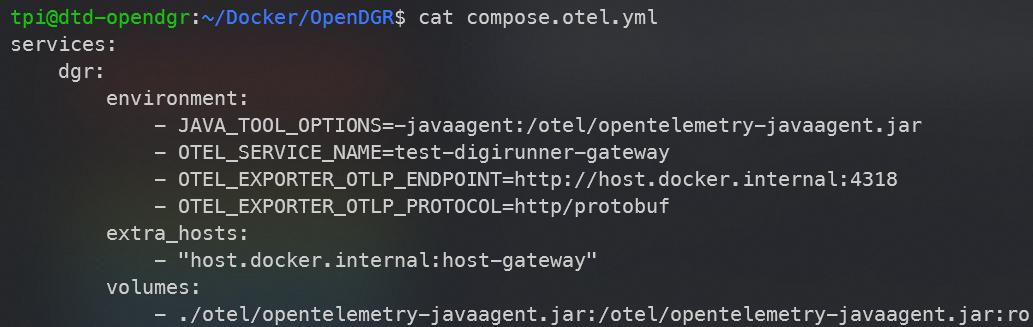
- 連線方式:這台主機上沒有以容器執行的 Collector,只有以系統服務執行的 Collector,所以容器透過主機位址連線;該 Collector 也需要加上 OTLP 接收與 traces pipeline。
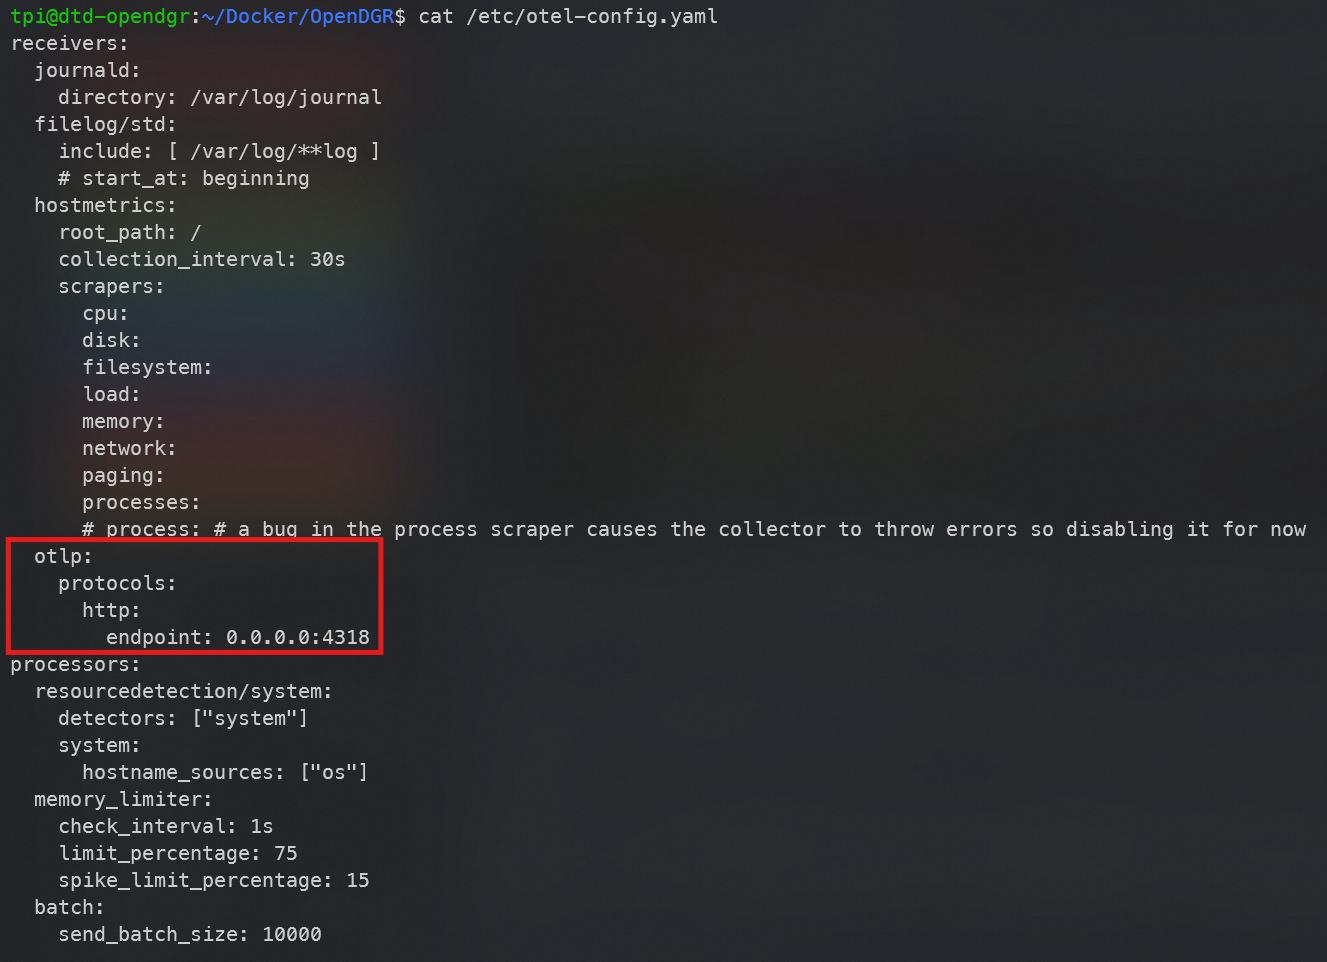
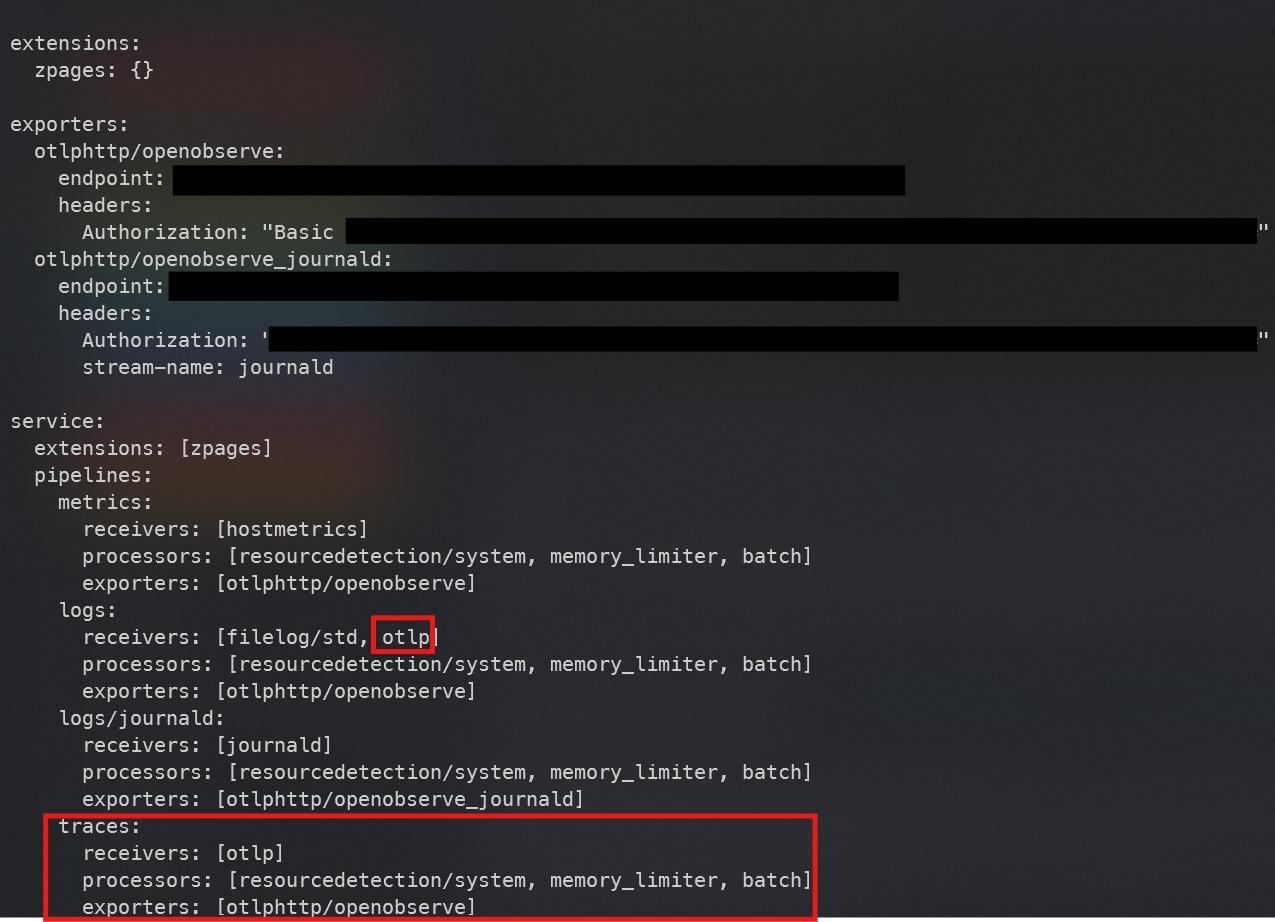
- **留意一:agent 預設會同時送出 traces、metrics、logs。**Java SDK 三種匯出器的預設值都是 otlp,Collector 沒有對應 pipeline 的訊號會被拒絕。測試階段可以把 OTEL_METRICS_EXPORTER 與 OTEL_LOGS_EXPORTER 設成 none,只保留需要的訊號。
- **留意二:JVM 只能在啟動時載入 agent。**容器必須重建,服務會短暫中斷,要選離峰時段,並先備份原本的設定。
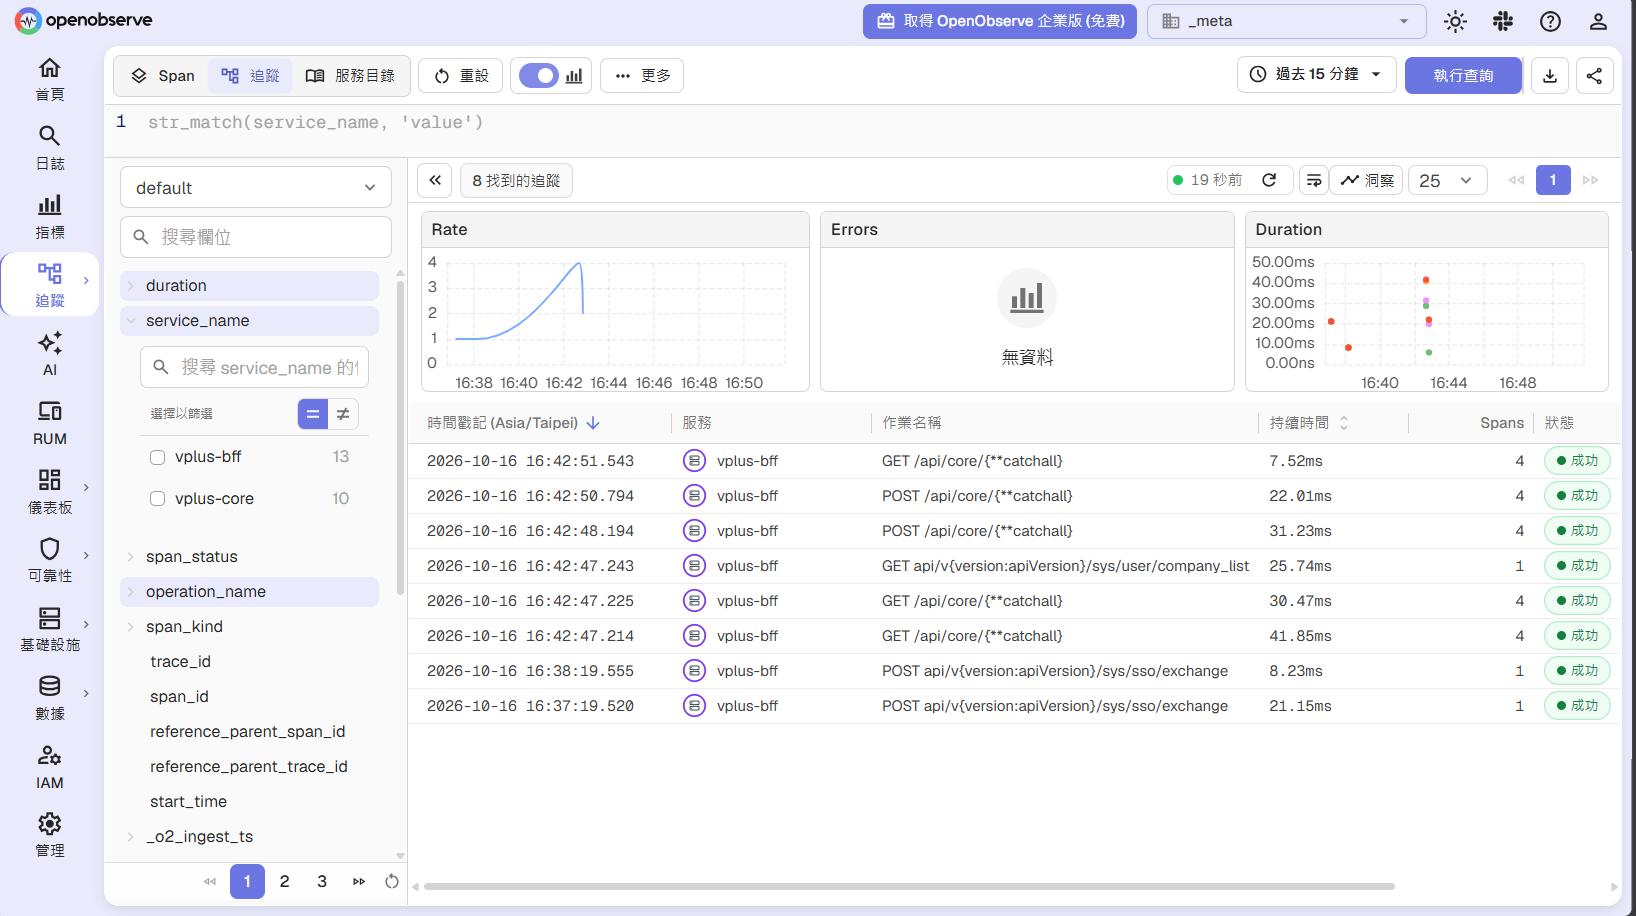
- 留意三:agent 送出的記錄,在有 span 的情況下會自動帶 trace_id 與 span_id,可以從追蹤直接跳到同一個請求的記錄。
- 結果:
7.3 兩個案例的共通點
- 應用程式端不用改程式碼:Node.js 靠 Operator 注入,Java 靠 agent 載入,動的都只是部署設定。
- 資料都先送到 Collector,再轉送到 OpenObserve:帳密只存在 Collector,與第六節的架構一致。
- 不同的執行環境與語言,進到同一個後端,用同一個介面查詢:這正是以 OTLP 為共通介面、後端統一的好處。
八、標準化:讓導入可以複製
要讓 OTel 變成團隊的標準作業,而不是每個專案各自摸索,我整理了一份規範,核心包含:
- 命名規則:service.name 採 team-service 格式,全小寫、以連字號分隔;環境資訊一律放在 deployment.environment.name(語意慣例 v1.27.0 起取代舊的 deployment.environment;實際採用哪一個,以所用檢測版本送出的欄位為準,並全團隊統一),值固定為 dev、uat、prod。
- 必填屬性:service.name、service.version、deployment.environment.name、team.owner(team.owner 為我自訂的屬性,不屬於 OTel 標準)。
- 全服務統一設定:例如 OTEL_PROPAGATORS 必須一致,否則跨服務的追蹤會斷掉。
- 各語言範本:Java、.NET、Node.js、Python 各有標準的 Dockerfile 片段與環境變數清單。
- 上線檢查清單:確認檢測版本與語言相符、命名符合規範、資料確實在平台上出現,並且 OpenObserve 的欄位列表中出現預期的欄位名稱(底線形式)。
8.1 欄位名稱對照:設定時用點號,查詢時用底線
OTel 的屬性名稱以點號分隔,例如 service.name,這是在應用程式的環境變數、Collector 設定與 OTTL 規則裡使用的寫法。但在 OpenObserve 中,這些點號會顯示為底線:Traces 頁面看到的是 service_name、db_name,查詢與警示裡用到的 host_name、http_url 也是同樣的轉換;指標名稱也一樣,例如 system.cpu.time 在 OpenObserve 是名為 system_cpu_time 的 stream。
- 對照:service.name 對應 service_name、service.version 對應 service_version、deployment.environment.name 對應 deployment_environment_name、team.owner 對應 team_owner。其中 service_name 已在 Traces 頁面確認,其餘是依相同規則推得,請在實際資料的欄位列表中確認。
- 哪裡用哪一種:應用程式的 OTEL_RESOURCE_ATTRIBUTES、Collector 的 resource 與 transform processor(OTTL,例如 attributes["service.name"])一律用點號;OpenObserve 的 SQL、PromQL、警示與儀表板篩選一律用底線,例如 WHERE service_name = ...。
- 兩種寫法不能混用:在 OpenObserve 查詢裡寫點號,或在 OTTL 裡寫底線,都對不到原本的欄位,結果是查不到資料,或設定到另一個不同的屬性。
- 規範管的是「值」,不是欄位名稱本身:全小寫、連字號、dev、uat、prod 這些規則管的是欄位的值,與欄位名稱的轉換無關。
- host_name 的值不受命名規則控制:它來自作業系統的主機名稱,例如 Windows 主機常是大寫的預設名稱;用 host_name 分組或建立警示時,要留意大小寫是否一致。
- 以實際畫面為準:規範文件建議附上「OTel 名稱與 OpenObserve 欄位」的對照表,並以 Traces、Logs、Metrics 頁面實際的欄位列表為準。
九、實測心得與踩雷紀錄
以下是我實際架設過程中遇到的問題,提供給之後要導入的同事參考:
- 資料沒出現,先查時間範圍。 查詢的時間區間太短,或測試資料的時間戳記是舊的,都會讓畫面看起來沒資料。
- 容器網路要想清楚。 Collector 的 receiver 要綁定 0.0.0.0,不能填特定 IP 或主機名稱;兩個獨立的 Docker Compose 專案預設在不同網路,彼此看不到對方,需要共用網路或改走主機連線;環境變數若同時被拿來當「自己監聽的位址」和「要送去的目標」,很容易出錯。
- journald 的資料需要整理。 journald receiver 預設會把整筆 journal 內容放進 body,severity 也會是 0,需要用 operators 把訊息與欄位拆開,再以 transform 把優先權對應成 severity。
- OTTL 函式名稱要查證。 例如轉小寫是 ToLowerCase,寫成其他名稱會直接解析失敗;欄位可能不存在時,要加上條件避免執行期警告。
- 範本面板沒資料,先看它查的是哪個 stream。 例如 Uptime 範本需要 httpcheck receiver 產生的指標;另外,httpcheck 對每個目標會同時產生各個狀態碼類別的序列,判斷成功時要限定 2xx,否則回傳 500 也可能被誤判為成功。
- Kubernetes 自動注入需要 Pod 重建才會生效。 建議把註解寫在 Deployment 的 Pod 範本,並透過 CI/CD 部署,先在測試環境驗證;一次重啟整個命名空間的風險較高,不建議在正式環境直接執行。
- 偵測機器下線要換個角度。 如果探測程式跑在被監控的機器自己身上,機器掛了探測也跟著停,只會看到「沒資料」而不是「失敗」,應該由另一台機器去探測。
- **欄位名稱在 Collector 與 OpenObserve 之間的寫法不同。**設定與 OTTL 用點號(service.name),OpenObserve 的查詢、警示與儀表板用底線(service_name);在 Collector 規則裡寫成底線,或在 SQL 裡寫成點號,都會對不上欄位(見 8.1)。
十、與常見替代方案的比較
沒有哪一個選擇適合所有情況,以下是我評估時的整理:
- 自建 Grafana 組合(Prometheus、Loki、Tempo、Grafana)
- 優點:生態與社群成熟,儀表板與外掛豐富,各元件可獨立擴充,彈性高。
- 代價:元件多,部署、升級、備份與權限都要各自維運。
- OpenObserve
- 優點:一體化,部署與維運單純,可用 SQL 查詢,原生支援 OTLP。
- 代價:專案相對年輕,社群與第三方整合規模較小;部分進階功能(例如單一登入、細緻的權限控管)可能屬於企業版,需依官方授權說明確認。
- 商業 SaaS 平台
- 優點:幾乎不用維運,功能完整。
- 代價:費用通常隨用量成長,且需考量資料存放位置與廠商鎖定。
十一、風險與限制
- 成熟度:相較於已經發展多年的方案,OpenObserve 的使用案例與社群資源較少,遇到問題時可參考的資料也較少。
- 授權:開源版與企業版的功能範圍不同,開源版的授權條款(AGPL)對內部使用與對外提供服務的影響,請與法務或資安確認,並以官方最新說明為準。
- 資料保留與備份:保留期限、備份與災難復原需要自行規劃。
- 個人資料:遙測資料可能夾帶個人資料,需要在 Collector 端先做遮蔽,不能假設應用程式不會輸出。
- 團隊能力:需要有人熟悉 OTel Collector 的設定與除錯,否則問題容易卡在資料進不來的環節。
- 效能與規模:我目前只做過小規模驗證,正式環境的資料量、查詢效能與高可用性,仍需另外評估。
十二、建議的導入路線
- 概念驗證:用單機容器架設 OpenObserve 與一個 Collector,接上一到兩個服務,確認三種訊號都能進來。
- 標準化:定案命名規範、必填屬性、各語言範本與上線檢查清單。
- 擴大範圍:建立多環境的本地 Collector 與中央 Gateway,建立儀表板範本與警示規則。
- 正式環境評估:高可用部署、保留與備份策略、權限與認證、成本實測。
可以用「從發現問題到找出原因所需的時間」作為成效指標,與導入前比較。
十三、快速試用
以下是最小的試用環境(帳號密碼請自行設定,不要使用範例值):
services:
  openobserve:
    image: o2cr.ai/openobserve/openobserve:latest
    container_name: openobserve
    networks:
      - openobserve
    ports:
      - "5080:5080"
    environment:
      ZO_ROOT_USER_EMAIL: "admin@example.com"
      ZO_ROOT_USER_PASSWORD: "請自行設定"
      ZO_COMPACT_DATA_RETENTION_DAYS: "30"
    volumes:
      - oo-data:/data
networks:
  openobserve: {}

volumes:
  oo-data:
Collector 的匯出設定(Authorization 是帳號與密碼以冒號相連後,做 base64 編碼的結果):
exporters:
  otlphttp/openobserve:
    endpoint: "http://openobserve:5080/api/default"
    headers:
      Authorization: "Basic <base64 編碼的帳號:密碼>"
    tls:
      insecure: true
接著在 service.pipelines 的 traces、metrics、logs 各自加上這個匯出器,用 curl 或任一個已檢測的服務送一筆資料,就能在 OpenObserve 介面看到結果。
結語
當 OTel 讓資料的產生變得標準化,後端平台的選擇就回到務實的問題:維運成本、查詢體驗、成本與彈性。OpenObserve 把記錄、指標、追蹤與警示放在同一處,對於人力有限、又希望避免被單一廠商綁住的團隊,是一個值得實測的選項。它不是沒有代價,但只要以 OTLP 與 Collector 作為穩定的中間層,就算日後調整後端,應用程式端的投入也不會白費。
延伸閱讀
- OpenObserve 官方文件:https://openobserve.ai/docs/
- OpenTelemetry 官方文件:https://opentelemetry.io/docs/
- OpenObserve 指標遷移指南(Mimir 與 Prometheus):https://openobserve.ai/docs/migration/migrate-from-grafana-to-openobserve/metrics/